

Źródło artykułu:
W
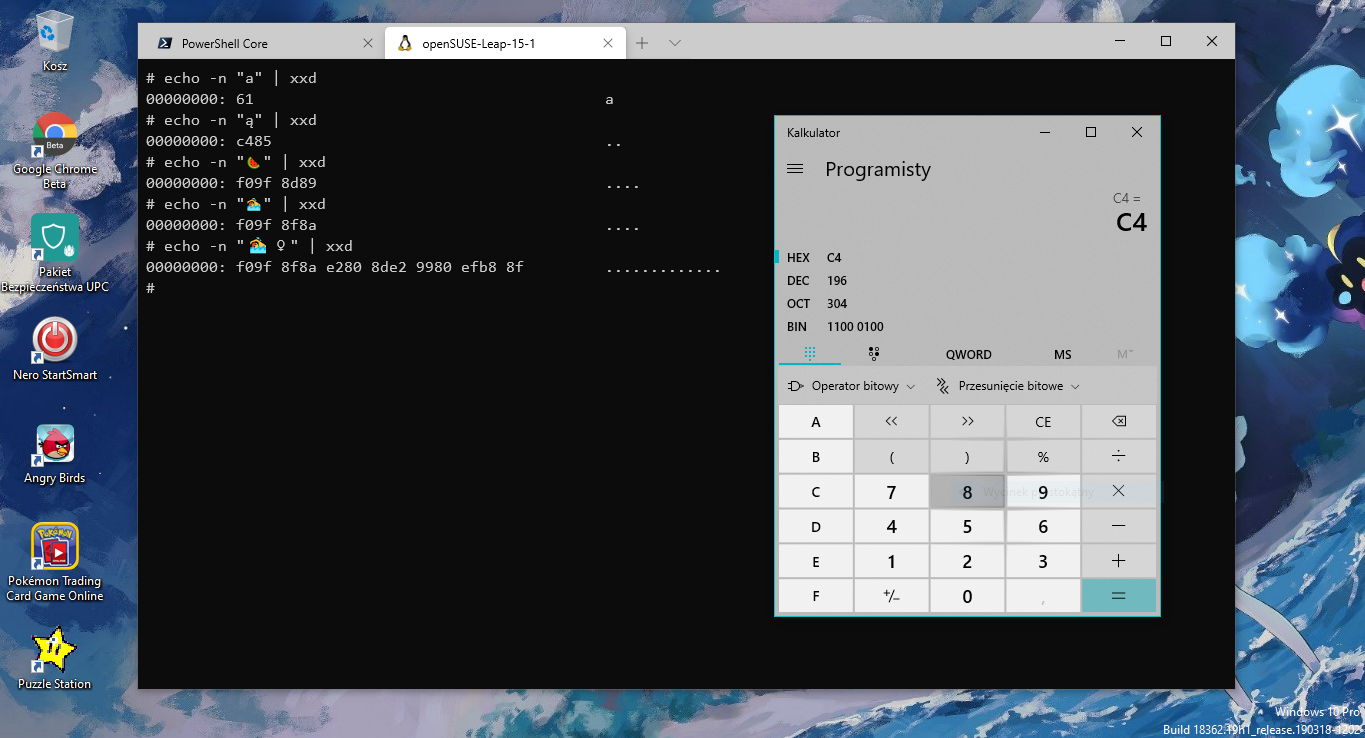
www.dobreprogramy.plW ostatnich częściach naszej dyskusji o plikach tekstowych udało się postawić tezę, że rozwiązaniem problemu stron kodowych i niewystarczającej liczby znaków możliwych do zakodowania w jednym bajcie jest kodowanie wielobajtowe. Jak się jednak prędko okazało, swobodne podejście do wykorzystywania kilku bajtów dla jednego symbolu potrafi wywołać wiele problemów i mieć całkiem sporo wad. Nie wspominając o różnorodności implementacji, zazwyczaj niezgodnych ze sobą.