OpenAI wprowadza textGrain: niewidoczny znak wodny w tekstach ChatGPT
OpenAI przygotowało rozwiązanie, które ma ułatwić rozpoznawanie treści generowanych przez ChatGPT nawet wtedy, gdy nigdzie nie ma widocznego oznaczenia. Nowy mechanizm – nazwany textGrain – "ukrywa się" w sposobie doboru słów, pozostawiając sygnał możliwy do odczytania przez specjalny detektor.
OpenAI stworzyło technologię pozwalającą identyfikować teksty powstałe przy użyciu sztucznej inteligencji. System textGrain działa jak niewidzialny znak wodny, z tą różnicą, że nie dotyczy obrazu ani dźwięku, lecz samego języka – ma wskazywać, że dany fragment został wygenerowany przez model.
Firma zapowiedziała, że w najbliższych tygodniach zacznie wdrażać to znakowanie w części odpowiedzi ChatGPT i Codex na terenie Unii Europejskiej. Równolegle użytkownicy korzystający z API OpenAI na całym świecie mają dostać możliwość dobrowolnego włączenia znakowania generowanego tekstu.
WIDEO
Byłem w chińskim Apple Storze. Porównałem ceny iPhone'ów z polskimi
Dlaczego akurat Unia Europejska?
Pierwszeństwo dla UE wynika z regulacji dotyczących sztucznej inteligencji. OpenAI rozwija textGrain m.in. po to, by spełniać wymagania AI Act, które przewidują obowiązek zapewnienia mechanizmów umożliwiających maszynową identyfikację treści wytwarzanych przez generatywne systemy AI.
W praktyce oznacza to, że to użytkownicy ChatGPT i Codex w Unii Europejskiej znajdą się wśród pierwszych osób, które zobaczą odpowiedzi "podpisane" niewidocznym sygnałem. OpenAI zastrzega przy tym, że na starcie nie planuje ustanowienia takiego znakowania jako standardu globalnego – chce najpierw sprawdzić, jak technologia działa w realnych zastosowaniach i gdzie ma słabe punkty.
Ukryty sygnał w doborze słów
Kluczowe jest to, że textGrain nie dopisuje do treści żadnej etykiety, komunikatu ani symbolu. Zamiast tego wykorzystuje statystyczny wzorzec "wpleciony" w decyzje modelu dotyczące wyboru słownictwa. Dla czytelnika tekst ma wyglądać naturalnie, natomiast dedykowany detektor potrafi sprawdzić, czy w analizowanym fragmencie występuje charakterystyczny sygnał pozostawiony przez modele OpenAI.
OpenAI podaje, że w wewnętrznych testach textGrain wypadał porównywalnie albo lepiej niż inne oceniane przez firmę podejścia, w tym SynthID dla tekstu. Jednocześnie firma podkreśla, że nie jest to metoda gwarantująca bezbłędne wykrywanie każdego materiału wygenerowanego przez AI.
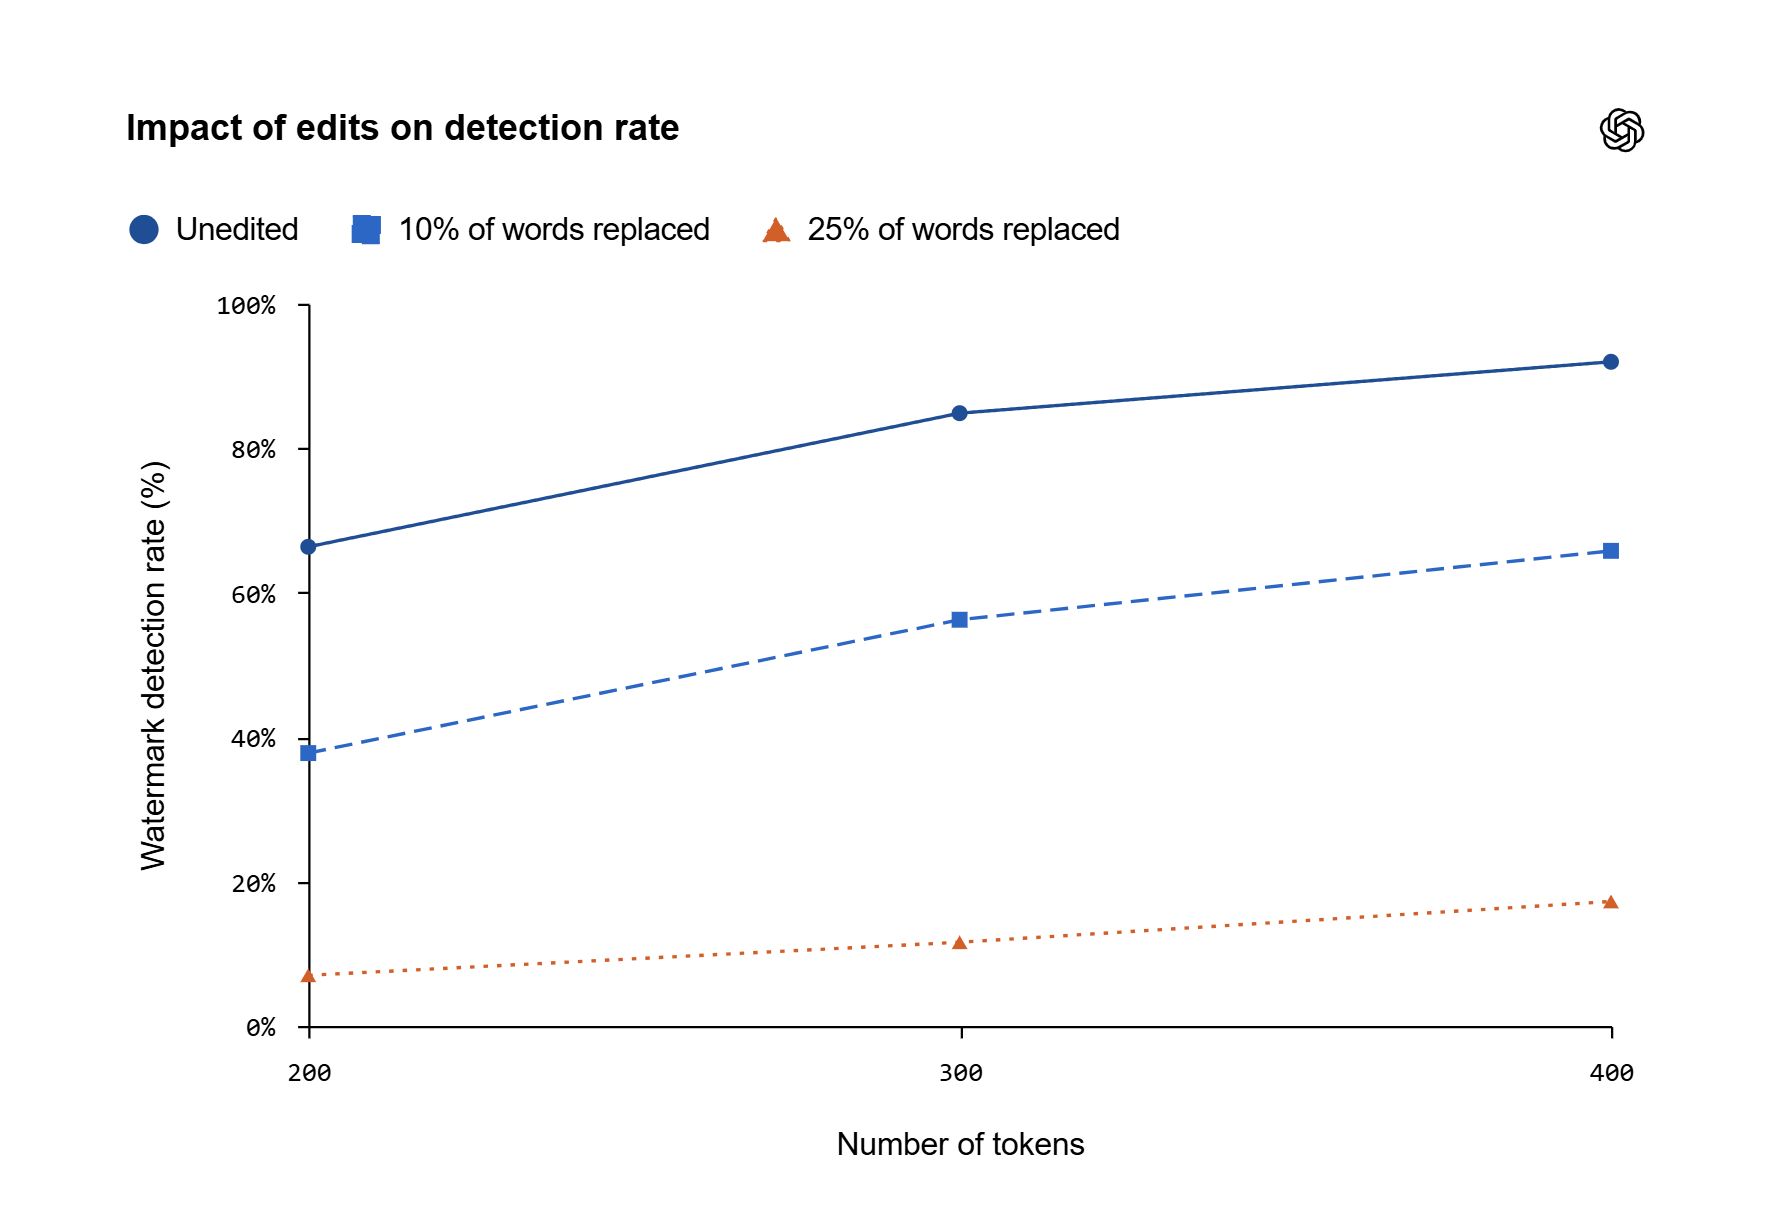
Najpoważniejszym wyzwaniem okazuje się podatność znaku na przeróbki. W testach OpenAI detektor poprawnie identyfikował około 92 proc. niezmienionych fragmentów o długości 400 tokenów. Gdy zastąpiono synonimami jedynie 10 proc. słów, skuteczność spadała do około 66 proc., a po zmianie 25 proc. słów wynosiła już tylko 17 proc.
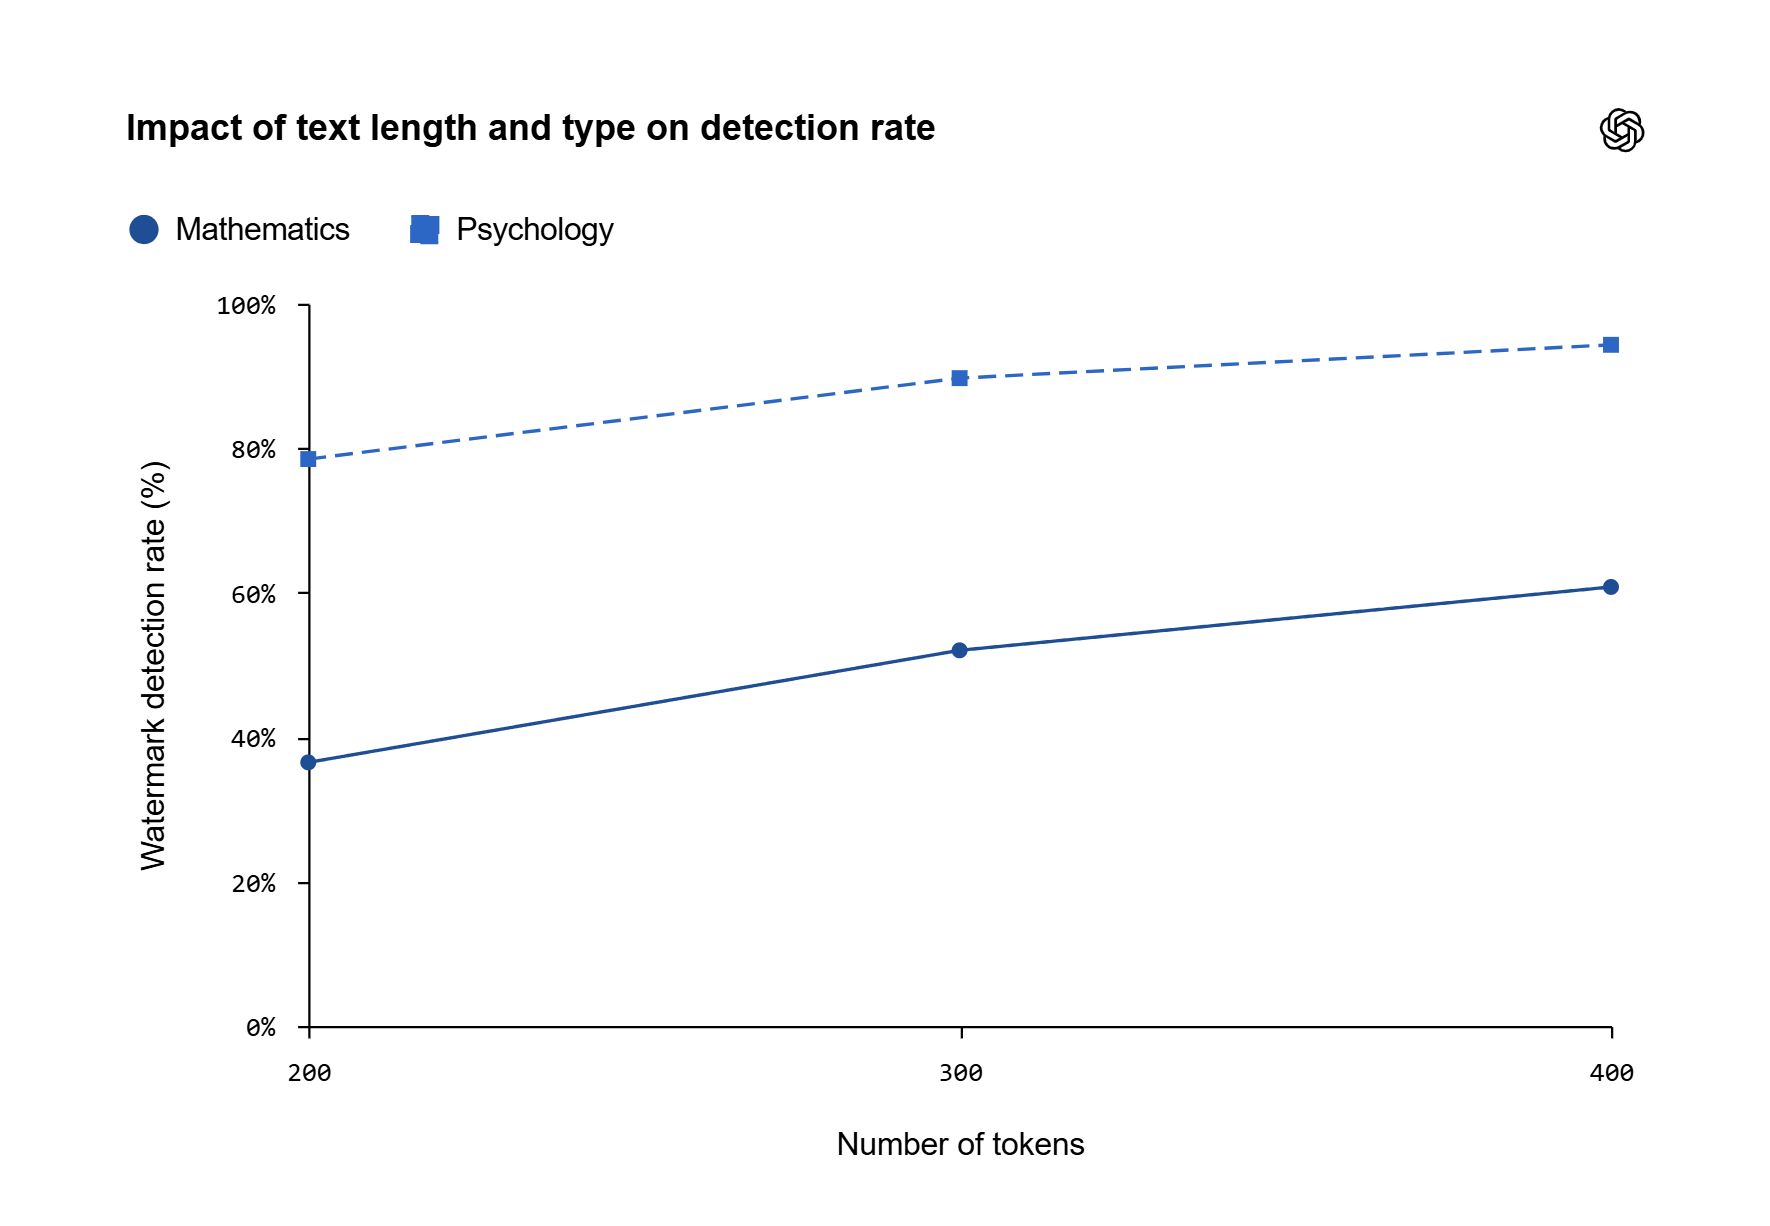
Wpływ ma także długość analizowanego tekstu. Przy założeniu poziomu fałszywych alarmów na poziomie 1 proc. system wykrywał oznaczenie w około 80 proc. fragmentów liczących 200 tokenów oraz w około 95 proc. fragmentów 400-tokenowych w przypadku treści z obszaru psychologii. Wyniki były wyraźnie słabsze dla matematyki, gdzie model ma mniejsze pole manewru w doborze słów.
W efekcie krótkie wpisy, mocno przeredagowane materiały albo odpowiedzi z dziedzin o ograniczonym słownictwie mogą być znacznie trudniejsze do sprawdzenia pod kątem obecności sygnału.
OpenAI zwraca uwagę na kolejne ograniczenie: sam fakt wykrycia znaku nie przesądza o tym, kto użył ChatGPT ani jak duży był udział AI w powstaniu tekstu. Oznaczenie nie pozwala ustalić autora, użytkownika, konta, promptu ani rozmowy, z której pochodzi treść. Nie rozstrzyga też, czy materiał jest prawdziwy ani czy został użyty zgodnie z prawem.
Równie istotne jest to, że brak wykrytego sygnału nie stanowi dowodu, że tekst napisał człowiek. Znak mógł zostać osłabiony przez edycję lub tłumaczenie, fragment mógł być zbyt krótki, a treść mogła powstać przy użyciu starszego lub nieobsługiwanego modelu albo narzędzia innej firmy.
OpenAI na razie nie udostępni detektora wszystkim
Choć samo znakowanie ma być dostępne szerzej, inaczej wygląda kwestia narzędzia do wykrywania. OpenAI umożliwiło składanie wniosków o dostęp do detektora, ale na początku ma on trafić jedynie do wybranych badaczy i organizacji eksperckich.
Firma uzasadnia takie podejście ryzykiem błędnych wskazań: detektor może wykryć znak tam, gdzie go nie ma, albo przeoczyć sygnał, który faktycznie znajduje się w tekście.
Jednocześnie OpenAI deklaruje, że w przyszłości chce udostępnić technologię textGrain w modelu open source.
To początek walki o pochodzenie treści
OpenAI przedstawia textGrain jako element szerszego podejścia do ustalania pochodzenia treści tworzonych przez AI. Firma korzysta już z podobnych mechanizmów w przypadku obrazów i dźwięku, m.in. z Content Credentials oraz niewidocznych znaków wodnych.
Dla tekstu sytuacja jest jednak bardziej skomplikowana, bo treści językowe można łatwo przepisać, przeredagować, przetłumaczyć albo zmieszać z fragmentami napisanymi przez człowieka. Z tego powodu OpenAI nie traktuje textGrain jako ostatecznego arbitra, który jednoznacznie rozstrzygnie, czy dany tekst napisała AI.
Na tym etapie firma planuje wdrożenie krok po kroku: w Unii Europejskiej znakowanie ma pojawić się w wybranych odpowiedziach ChatGPT i Codex w najbliższych tygodniach. OpenAI ma obserwować efekty w praktyce, a następnie rozwijać zarówno sam mechanizm znakowania, jak i metody wykrywania treści generowanych przez AI.
Paweł MaziarzRedaktor prowadzący serwis benchmark.pl
Redaktor prowadzący serwis Benchmark.pl, dziennikarz technologiczny z ponad 15-letnim doświadczeniem. Specjalizuje się w tematach związanych ze sprzętem komputerowym, rozwojem technologii AI oraz trendami w branży IT. W swojej pracy stawia na rzetelność, praktyczne podejście i pasję do nowinek technologicznych, koncentrując się na ocenie produktów pod kątem ich wartości i opłacalności dla użytkowników. W wolnym czasie angażuje się w wolontariat, aktywnie spędza czas oraz rozwija swoje zainteresowania i pasje.