

Źródło artykułu:
W
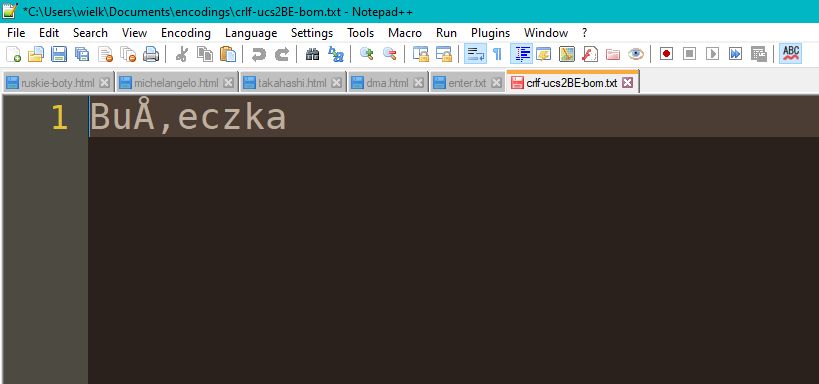
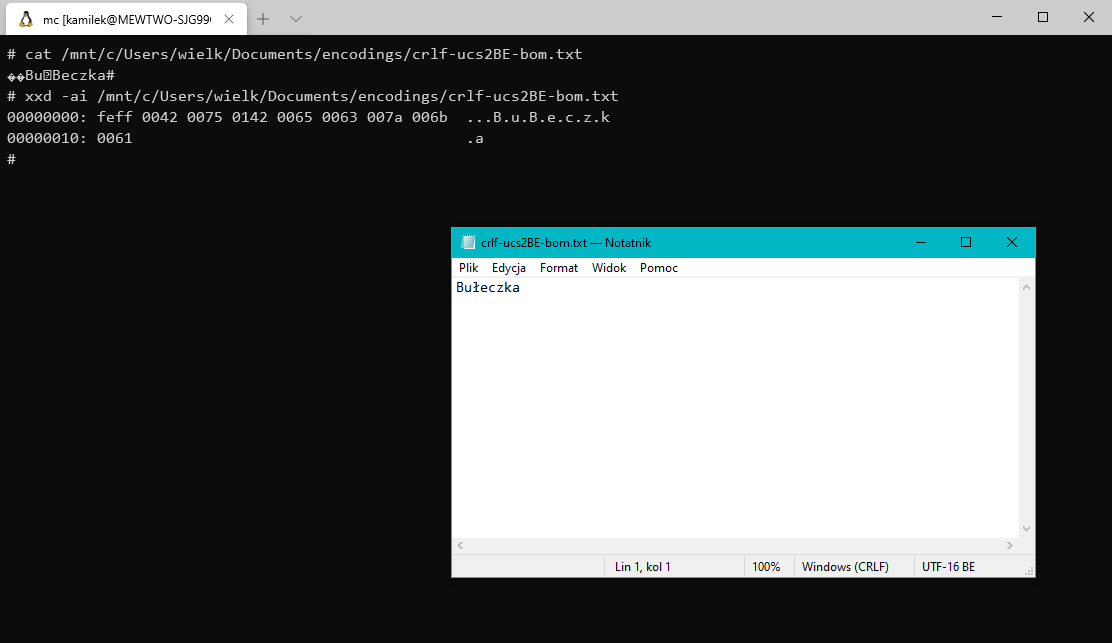
www.dobreprogramy.plUstaliliśmy ostatnio, że jeden bajt na znak to za mało, a ponieważ stać nas na więcej, świat rozpoczął implementowanie różnych metod kodowania stosujących wiele bajtów. Na czym polegają problemy z zastosowaniem takiego kodowania? Wydaje się ono rozwiązaniem bolączki, jaką są strony kodowe i zregionalizowane, nieprzenośne ustawienia zbiorów znaków. Co może pójść źle podczas przejścia na Unicode implementowany w postaci wielobajtowych, "szerokich" znaków (wide character, wchar)?